ZAOSEQ LABS / LANGUAGE & INTERACTION v0.3.0 Research Preview
造序注音
ZaoSeq Bopomofo · 造序科技
造序注音是可在瀏覽器操作的注音選字研究版本。系統依輸入的注音產生讀音合法的候選,再結合語料統計與上下文排列候選。v0.3.0 公開研究核心;下方線上示範以公開的 v0.3.0 decoder 產生候選,再由 v0.2 的排序模型排序。
LIVE DEMO
注音輸入與候選結果
可使用畫面注音鍵盤,或將實體鍵盤切換至英數模式後依大千鍵位輸入。候選由推論服務即時產生。
使用畫面鍵盤、實體鍵盤或範例輸入注音。
DECODING PIPELINE
選字流程
- 注音輸入
- ZaoSeq Decoder
- 合法候選序列
- Corpus + Lexicon Ranking
- Fine-tuned Contextual Ranker
- 最終輸出
模型只在造序 decoder 產生、且讀音合法的候選中重新排序,不自由生成中文。Fine-tuned from Laya Multilingual for contextual candidate ranking.
INPUT TOLERANCE / IN PROGRESS
注音輸入容錯
造序注音正在實驗結合整句上下文與注音距離,從有限的合法候選中找回較可能的輸入。
推論服務提供修正資訊時,未確認的注音會顯示低干擾提示;已確認文字仍由使用者控制。
RELEASE / v0.3.0
v0.3.0 公開研究核心
新增高階字元 n-gram、Witten–Bell / Kneser–Ney 語言模型、混合模型與繁體字形檢查 decoder。小型範例可在自己的電腦上離線執行。
公開注音解析、詞庫、候選產生、語料授權稽核與評估介面。260 項公開元件測試通過,逐檔白名單與機密掃描通過。
本版沒有新增正式 benchmark;正式品質報告將在封存評估完成後另行發布。線上示範的候選由本次公開的 decoder 產生,排序模型沿用 v0.2、未隨本版公開。
RESEARCH STATUS / v0.2 歷史結果
TEST-V1 封存評估
以下為 v0.2 的歷史評估,保留供查閱,不能視為 v0.3.0 的品質驗證。
設定先於新測試集凍結,正式評估只執行一次。v0.2 加入經核准的日常語料與詞表,改善 decoder 的候選覆蓋與排序。
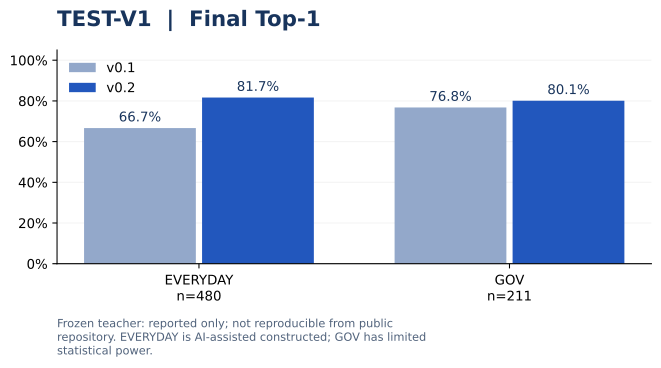
EVERYDAY 480 句,為 AI 輔助建構,句型可能比真實輸入規整;89 句由錯變對、17 句由對變錯(exact McNemar p = 5.9 × 10⁻¹³)。GOV 211 句,統計檢定力有限。這些不是與商用輸入法的直接比較。
目前仍是 Research Preview:沒有正式 production runtime validation,不公布正式延遲;也不是 Windows 或 macOS 系統輸入法。注音容錯預設關閉。
閱讀完整測試方法與 Technical NotesPRIVACY
資料處理方式
不需要帳號。輸入內容僅用於當次推論,不儲存,也不作為模型訓練資料。
選擇公開服務時,送出才會向本站 API 傳送前文與注音;選擇本機服務時,瀏覽器僅連接同一裝置上的 127.0.0.1。本機連接器只轉送給同一裝置的模型 API。未送出的 composition 只留在頁面。本站沒有輸入內容分析工具;本站代理與推論程式不記錄輸入內容。基礎設施可能記錄連線資訊;請勿輸入敏感資料。
DATA & LICENSE
資料與授權
字音資料使用 CNS11643 中文標準交換碼全字庫,來源為數位發展部,依政府資料開放授權條款第 1 版(Open Government Data License Taiwan 1.0)使用。Laya Multilingual 為 Apache-2.0 第三方模型,所含 mmBERT encoder 依 MIT 授權。
v0.2 的研究語料另使用 Tatoeba 與 Mozilla Common Voice 27.0 zh-TW;各資料的用途與授權依公開匯出紀錄列示,不適用程式碼的 Apache-2.0。政府資料來源 · 日常語料來源。
資料與第三方授權自行執行造序注音
公開倉庫提供注音解析、decoder、詞庫、語料工具與測試。v0.3.0 Release 提供原始碼與離線範例,不含私有 teacher checkpoint、推論服務或部署資料;下載後不能直接重現公開 Demo 的情境排序。已自行備妥相容 API 者可在上方選擇本機服務。公開 Demo 只顯示實際 API 結果;服務未就緒時不會顯示模擬結果。
查看 v0.3.0 GitHub Release