v0.2 RESEARCH PREVIEW / TECHNICAL NOTES
研究狀態與資料來源
造序注音先由自建 decoder 產生讀音合法的候選,再由情境模型排序。v0.2 加入政府資料與經核准的日常語料統計、衍生詞表;情境模型延用凍結的 teacher,不自由生成中文字。線上示範以公開的 v0.3.0 decoder 產生候選,情境模型沿用 v0.2。
新的封存測試 TEST-V1
v0.2 的設定與選擇規則先在 DEV 上確定,之後建立新的 TEST-V1,正式評估只執行一次。下表為整句首選與 decoder 指標;寫法變體依測試規則處理。這是造序內部評估,並非與商用輸入法的直接比較,也不代表即時 Demo 的準確率。
| 指標 | v0.1 | v0.2 |
|---|---|---|
| EVERYDAY final Top-1 · 480 句 | 66.7% | 81.7% |
| EVERYDAY decoder Top-1 | 49.6% | 65.8% |
| EVERYDAY decoder R@3 | 69.2% | 84.4% |
| EVERYDAY decoder R@5 | 75.4% | 90.0% |
| EVERYDAY decoder R@10 | 82.1% | 92.3% |
| GOV final Top-1 · 211 句 | 76.8% | 80.1% |
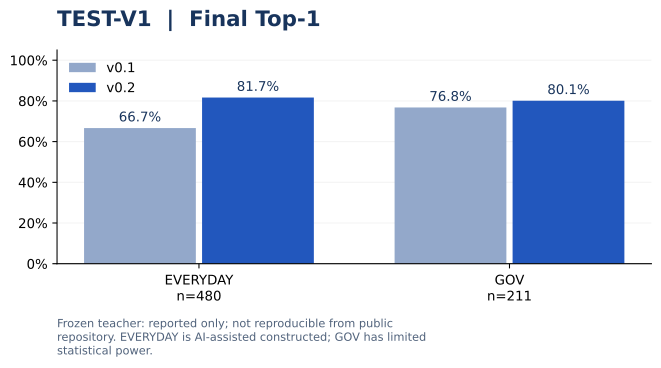
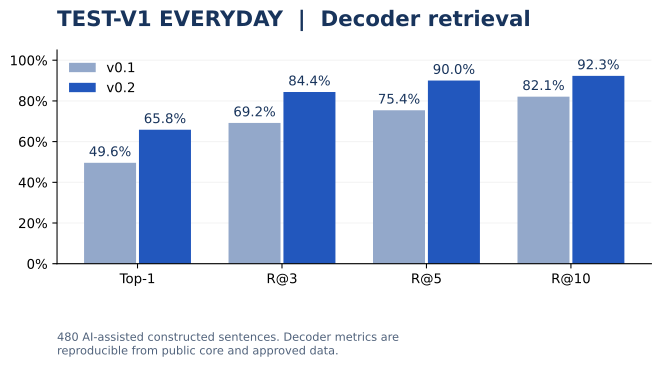
EVERYDAY final 有 89 句由錯變對、17 句由對變錯;exact McNemar p = 5.9 × 10⁻¹³。EVERYDAY 是 AI 輔助建構的 480 句,句型可能比真實使用者輸入規整。GOV 只有 211 句,統計檢定力有限。完整的測試規則、結果與判定見 公開測試報告與 正式 JSON。
可重現範圍與限制
公開倉庫包含 decoder、詞庫、語料工具及評估框架,不含私有 frozen teacher checkpoint、權重、推論服務或部署。final Top-1 是 reported-only,無法僅靠公開倉庫重現。v0.2 尚無正式 production runtime validation,因此不公布官方延遲數字;這也是 Research Preview,並非 Windows 或 macOS 系統輸入法。
資料與授權
CNS11643 字音資料與已啟用的政府語料依各自來源授權。v0.2 的日常語料含 Tatoeba 與 Mozilla Common Voice 27.0 zh-TW;只使用 Common Voice 的句子 id 與句子文字,不使用說話者資料。各來源的允許用途、授權與歸屬請以公開匯出紀錄為準,原始語料不隨 Release 附件提供。Laya Multilingual 為 Apache-2.0 第三方模型,所含 mmBERT encoder 依 MIT 授權。